OCR Là Gì? Từ OCR Đến Document AI Cho Doanh Nghiệp
Tóm tắt nhanh
OCR (Optical Character Recognition, nhận dạng ký tự quang học) là công nghệ chuyển chữ trong ảnh chụp, bản scan hoặc file PDF dạng ảnh thành văn bản mà máy tính đọc, tìm kiếm và chỉnh sửa được. Với doanh nghiệp, OCR chỉ là tầng đầu tiên: điều cần có là dữ liệu đúng trường, đúng nghĩa và nằm đúng chỗ trong hệ thống. Đó là việc của Document AI, tức OCR kết hợp với AI để phân loại tài liệu, trích xuất thông tin, kiểm tra và đưa dữ liệu vào ERP, CRM hay phần mềm nghiệp vụ. Các dự án Savvycom đã triển khai cho thấy mức giảm thời gian xử lý hồ sơ phổ biến từ 50% đến 70%, với thời gian từ khởi động đến vận hành chính thức khoảng 3 đến 5 tháng ở các dự án có mốc đo.
1. OCR là gì?
OCR là viết tắt của Optical Character Recognition, trong tiếng Việt gọi là nhận dạng ký tự quang học. Công nghệ này nhận đầu vào là một hình ảnh có chữ, có thể là hóa đơn chụp bằng điện thoại, hợp đồng scan hay tờ khai viết tay, và trả về văn bản dạng số mà máy tính xử lý được. Nhờ vậy, một kho hồ sơ giấy vốn chỉ đọc được bằng mắt có thể tìm kiếm theo từ khóa, sao chép, lưu trữ và đưa vào các hệ thống khác.
Người dùng cá nhân đã quen với OCR qua những tính năng như quét chữ trên ảnh của điện thoại, chuyển PDF sang Word hay dịch biển hiệu bằng camera. Ở quy mô doanh nghiệp, câu chuyện khác hẳn: mỗi ngày có hàng trăm đến hàng nghìn chứng từ, hồ sơ và hợp đồng đi qua các phòng ban, và đòi hỏi không dừng ở việc “đọc được chữ” mà là lấy đúng số tiền, đúng mã số thuế, đúng điều khoản để hệ thống xử lý tiếp mà không cần người nhập lại.
2. OCR hoạt động như thế nào?
Một hệ thống OCR xử lý tài liệu qua bốn bước: làm sạch ảnh, xác định vùng có chữ, nhận dạng từng ký tự hoặc từng dòng chữ, rồi hiệu chỉnh kết quả theo từ điển và ngữ cảnh.
- Tiền xử lý ảnh. Ảnh đầu vào được xoay thẳng, khử nhiễu, tăng độ tương phản và tách nền. Đây là bước quyết định nhiều nhất tới độ chính xác, vì bản scan nghiêng, ảnh chụp thiếu sáng hay bản photo mờ đều làm kết quả sụt giảm rõ rệt.
- Phát hiện vùng chữ. Hệ thống xác định đâu là đoạn văn, đâu là bảng, tiêu đề, chữ ký hay con dấu, để không đọc lẫn chữ giữa các cột hay đọc cả hoa văn nền thành ký tự.
- Nhận dạng ký tự. OCR thế hệ cũ so khớp hình dạng từng ký tự với mẫu có sẵn. Các mô hình hiện nay dùng học sâu để đọc cả dòng chữ cùng lúc, nhờ đó xử lý tốt hơn nhiều với phông chữ lạ, chữ viết tay và dấu tiếng Việt.
- Hậu xử lý. Kết quả được đối chiếu với từ điển, định dạng dữ liệu (ngày tháng, số tiền, mã số thuế) và ngữ cảnh để sửa những lỗi nhận nhầm phổ biến, chẳng hạn chữ “O” với số “0”.
Thị trường hiện có đủ lựa chọn cho từng nhu cầu: thư viện mã nguồn mở như Tesseract, PaddleOCR hay VietOCR (chuyên cho tiếng Việt), dịch vụ đám mây như Google Cloud Document AI, Azure AI Document Intelligence, Amazon Textract, cùng các nền tảng OCR tiếng Việt của doanh nghiệp trong nước. Với nhu cầu đọc chữ thuần túy trên tài liệu rõ nét, những công cụ này đều đáp ứng tốt.
3. OCR và Document AI khác nhau thế nào?
Sự khác biệt nằm ở câu hỏi mỗi công nghệ trả lời được. OCR trả lời câu hỏi “trên ảnh này viết gì?”. Document AI, còn gọi là xử lý tài liệu thông minh (IDP), trả lời câu hỏi mà doanh nghiệp thật sự quan tâm: “đây là loại giấy tờ gì, thông tin nào cần lấy, thông tin đó có hợp lệ không và cần chuyển tới đâu?”. Để làm được điều đó, OCR được đặt trong một chuỗi xử lý gồm bốn tầng:
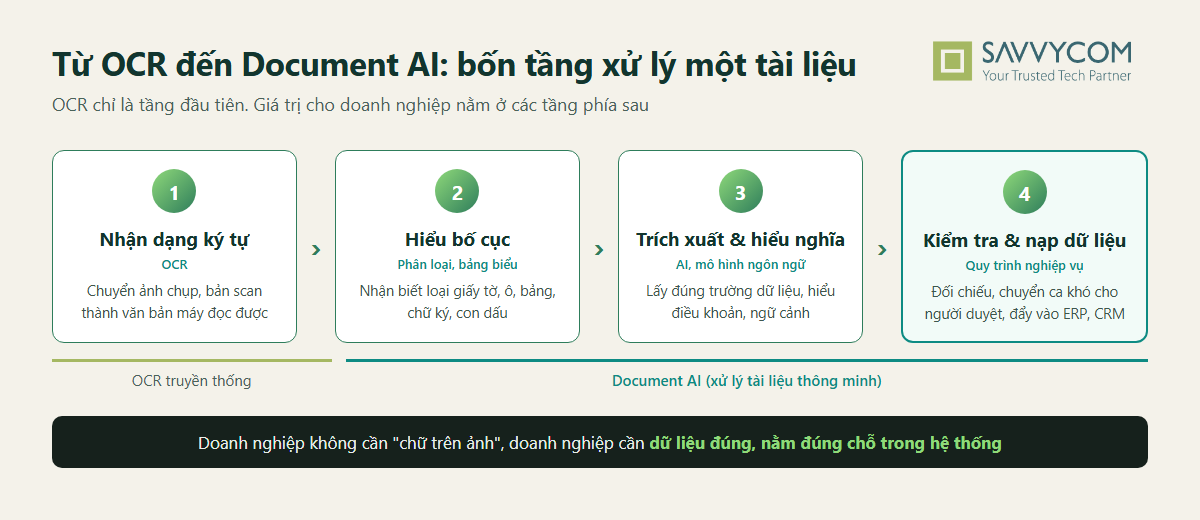
Tầng 2 và tầng 3 là nơi AI tạo ra khác biệt. Mô hình thị giác máy tính nhận biết bố cục và loại tài liệu; mô hình ngôn ngữ lớn hiểu nội dung, nhờ đó trích xuất được thông tin ngay cả khi mỗi nhà cung cấp trình bày hóa đơn một kiểu, hay khi một điều khoản quan trọng nằm lẫn trong trang thứ ba mươi của hợp đồng. Tầng 4 đưa kết quả vào quy trình nghiệp vụ: đối chiếu với dữ liệu sẵn có, tự động duyệt trường hợp rõ ràng và chuyển trường hợp chưa chắc chắn cho chuyên viên xác nhận.
| Tiêu chí | OCR truyền thống | Document AI |
|---|---|---|
| Đầu ra | Văn bản thô | Dữ liệu có cấu trúc theo từng trường, kèm mức độ tin cậy |
| Tài liệu phù hợp | Mẫu cố định, in rõ nét | Nhiều mẫu khác nhau, có bảng biểu, chữ viết tay, bản vẽ |
| Hiểu nội dung | Không | Có: phân loại tài liệu, hiểu điều khoản, ngữ cảnh |
| Kiểm soát sai sót | Người dùng tự rà lại toàn bộ | Chỉ chuyển trường hợp chưa chắc chắn cho người duyệt |
| Kết nối hệ thống | Xuất file, nhập tay sang phần mềm khác | Đẩy thẳng vào ERP, CRM, phần mềm nghiệp vụ |
4. Ứng dụng OCR và Document AI trong doanh nghiệp
Những ví dụ dưới đây đều là dự án Savvycom đã trực tiếp đồng hành triển khai, với kết quả đo được sau khi hệ thống đi vào vận hành. Điểm chung của chúng: bài toán không bao giờ dừng ở việc đọc chữ.
- Tài chính, ngân hàng: định danh khách hàng điện tử (eKYC). Thông tin trên giấy tờ tùy thân được nhận dạng và điền thẳng vào hồ sơ mở tài khoản, kết hợp đối chiếu khuôn mặt và phát hiện giấy tờ giả. Với một nhà cung cấp dịch vụ tài chính số tại Philippines, giải pháp giúp giảm hơn 60% khối lượng xác minh thủ công và giảm hơn 50% thiệt hại do gian lận danh tính.
- Logistics: rà soát hợp đồng. Hợp đồng vận chuyển dài hàng chục trang, điều khoản về trách nhiệm, phụ phí và thời hạn nằm rải rác. Hệ thống AI phân tích hợp đồng Savvycom xây cho một tập đoàn logistics tại Hàn Quốc tự động trích xuất điều khoản trọng yếu với độ chính xác 95%, rút ngắn 50% thời gian rà soát mỗi hợp đồng sau 3 tháng triển khai.
- Bảo hiểm và pháp lý: xử lý hồ sơ bồi thường. Mỗi vụ việc kèm bộ hồ sơ từ hàng chục tới hàng trăm trang. Giải pháp AI xử lý hồ sơ bồi thường bảo hiểm cho một hãng dịch vụ pháp lý tại Mỹ giúp giảm 60% thời gian rà soát mỗi bộ hồ sơ, mỗi kết luận đều dẫn chiếu về đúng trang tài liệu gốc để chuyên viên kiểm tra.
- Y tế: số hóa hồ sơ bệnh nhân. Phiếu tiếp nhận, kết quả xét nghiệm, hồ sơ bảo hiểm y tế là những loại tài liệu vừa nhiều mẫu vừa nhạy cảm. Hệ thống Document Intelligence kết hợp OCR với mô hình ngôn ngữ mà Savvycom triển khai cho một tổ chức y tế tại Mỹ giúp giảm từ 50% đến 70% khối lượng nhập liệu thủ công.
- Xây dựng, sản xuất: số hóa bản vẽ kỹ thuật. Bản vẽ là dạng tài liệu khó nhất vì chữ, ký hiệu và hình khối đan xen. Với một tập đoàn xây dựng Nhật Bản, Savvycom kết hợp mô hình thị giác máy tính YOLO-v8 với PaddleOCR để đọc ký hiệu và thông số, tăng 65% tốc độ xử lý bản vẽ và giảm 20% chi phí vận hành quy trình số hóa sau 5 tháng.
Ngoài các lĩnh vực trên, nhóm ứng dụng phổ biến nhất tại doanh nghiệp Việt Nam là xử lý chứng từ kế toán (hóa đơn, phiếu nhập kho, bảng kê), số hóa kho hồ sơ lưu trữ và tự động hóa khâu tiếp nhận hồ sơ khách hàng ở ngân hàng, bảo hiểm, bệnh viện.
5. Những khó khăn khi OCR tài liệu tiếng Việt
Tiếng Việt là ngôn ngữ khó với OCR vì hệ thống dấu thanh dày đặc: chỉ cần nhận nhầm một dấu là nghĩa của từ, thậm chí tên người, thay đổi hoàn toàn. Bên cạnh đó, tài liệu tại doanh nghiệp Việt Nam có một số đặc thù cần tính trước khi chọn giải pháp:
- Con dấu đỏ và chữ ký đè lên chữ ở phần quan trọng nhất của văn bản, thường là tên người ký, ngày tháng và số tiền.
- Kho hồ sơ cũ in bằng phông chữ đời trước, giấy ngả màu, bản photo nhiều lần làm nét chữ đứt gãy.
- Chữ viết tay trên tờ khai, phiếu tiếp nhận, phiếu kho, với độ chính xác thấp hơn đáng kể so với chữ in.
- Mẫu biểu thiếu thống nhất: cùng là hóa đơn hay phiếu xét nghiệm nhưng mỗi đơn vị phát hành một bố cục khác nhau, khiến cách làm dựa trên tọa độ cố định nhanh chóng bộc lộ hạn chế.
Vì vậy, độ chính xác công bố của một công cụ OCR chỉ mang tính tham khảo. Con số có ý nghĩa là độ chính xác đo trên chính bộ tài liệu thật của doanh nghiệp, và đó là lý do mọi dự án nghiêm túc nên bắt đầu bằng một giai đoạn thử nghiệm trên dữ liệu thật.
6. Doanh nghiệp nên bắt đầu từ đâu?
Nếu tài liệu có mẫu cố định, số lượng vừa phải và chỉ cần đọc chữ, một dịch vụ OCR có sẵn là đủ và tiết kiệm hơn. Khi tài liệu nhiều mẫu, cần hiểu nội dung, cần kiểm soát sai sót và phải đưa dữ liệu vào hệ thống nghiệp vụ, doanh nghiệp cần một giải pháp Document AI được thiết kế theo quy trình của mình.
Từ kinh nghiệm triển khai, chúng tôi khuyến nghị lộ trình bốn bước:
- Chọn đúng một loại tài liệu tốn nhiều công nhập liệu nhất và có tác động rõ tới chi phí hoặc tốc độ phục vụ khách hàng. Đừng bắt đầu bằng mục tiêu “số hóa toàn bộ”.
- Thử nghiệm trên dữ liệu thật trong vài tuần, đo độ chính xác theo từng trường thông tin thay vì một con số chung cho cả văn bản.
- Thiết kế cơ chế người duyệt cho các trường hợp hệ thống chưa chắc chắn. Mục tiêu thực tế là giảm phần lớn khối lượng nhập liệu, không phải loại bỏ hoàn toàn vai trò con người.
- Kết nối vào hệ thống đang dùng để dữ liệu chảy thẳng vào ERP, CRM hay phần mềm nghiệp vụ, sau đó mới mở rộng sang loại tài liệu tiếp theo.
Chi phí triển khai phụ thuộc vào số loại tài liệu, sản lượng xử lý, yêu cầu bảo mật dữ liệu (xử lý trên đám mây hay tại hạ tầng nội bộ) và mức độ tích hợp. Cách làm tiết kiệm là bắt đầu từ bản thử nghiệm với một loại tài liệu, đo hiệu quả rồi mới quyết định mở rộng. Để đặt Document AI trong bức tranh lớn hơn, bạn có thể tham khảo cách chọn bài toán trong bài ứng dụng AI cho doanh nghiệp, và khi muốn AI không chỉ đọc tài liệu mà tự xử lý trọn quy trình phía sau, hãy xem thêm về AI Agent. Savvycom cũng đóng gói năng lực AI theo dữ liệu riêng của doanh nghiệp trong giải pháp AI tùy chỉnh SavvyGPT.
Câu hỏi thường gặp
1. OCR là viết tắt của từ gì?
OCR là viết tắt của Optical Character Recognition, nghĩa là nhận dạng ký tự quang học: công nghệ chuyển chữ trong ảnh chụp, bản scan hoặc file PDF dạng ảnh thành văn bản máy tính đọc và chỉnh sửa được.
2. OCR có đọc được tiếng Việt có dấu không?
Có. Các mô hình học sâu hiện nay đọc tiếng Việt có dấu với độ chính xác cao trên tài liệu in rõ nét. Độ chính xác giảm với chữ viết tay, bản photo mờ, con dấu đè chữ hay phông chữ cũ, vì vậy nên đo trên chính bộ tài liệu thật của doanh nghiệp trước khi triển khai.
3. OCR khác Document AI như thế nào?
OCR chỉ chuyển chữ trên ảnh thành văn bản. Document AI kết hợp OCR với AI để phân loại tài liệu, trích xuất đúng trường thông tin, hiểu nội dung, kiểm tra tính hợp lệ và đưa dữ liệu vào hệ thống nghiệp vụ như ERP, CRM.
4. Doanh nghiệp nên dùng dịch vụ OCR có sẵn hay xây giải pháp riêng?
Dùng dịch vụ có sẵn khi tài liệu có mẫu cố định, số lượng vừa phải và chỉ cần đọc chữ. Nên xây giải pháp riêng khi tài liệu nhiều mẫu, cần hiểu nội dung, có yêu cầu bảo mật dữ liệu nghiêm ngặt hoặc phải tích hợp sâu vào quy trình và hệ thống đang dùng.
5. Triển khai Document AI mất bao lâu?
Giai đoạn thử nghiệm với một loại tài liệu thường mất vài tuần. Các dự án Savvycom đã triển khai có mốc đo đi vào vận hành chính thức sau khoảng 3 đến 5 tháng, tùy độ phức tạp của tài liệu và mức độ tích hợp, với mức giảm thời gian xử lý phổ biến từ 50% đến 70%.
Doanh nghiệp vẫn đang nhập liệu thủ công từ chứng từ, hồ sơ, hợp đồng?
Savvycom đồng hành từ khâu chọn loại tài liệu đáng tự động hóa nhất, thử nghiệm trên dữ liệu thật, đến triển khai giải pháp Document AI và kết nối với hệ thống doanh nghiệp đang dùng. Mỗi đề xuất đều bắt đầu bằng con số đo được trên chính tài liệu của bạn.
Xem năng lực đã kiểm chứng: Dự án tiêu biểu của Savvycom
Điện thoại: +84 24 3202 9222
Hotline: +84 352 287 866
Email: [email protected]